En bref. Depuis la mi-septembre 2026, les quotas hebdomadaires de Claude Code ont baissé et les plaintes de quotas vidés en un jour se multiplient. rightsize, un plugin Claude Code créé par Ayoub Hammoudi (LinkedIn), applique une règle simple : la qualité d'abord, l'économie ensuite. Ses mesures, publiées et reproductibles, montrent qu'au-delà de l'effort « medium », la qualité n'augmente plus sur des tâches vérifiables, alors que le coût, lui, peut être multiplié par 9.
Le problème : on paie la qualité au mauvais endroit
Un agent de code mal piloté coûte cher de deux façons. Soit il rend un travail approximatif qu'il faudra reprendre. Soit il dépense des tokens là où ça ne change rien : le plus gros modèle pour lire un fichier, toute la suite de tests pour une ligne modifiée, la même analyse refaite plusieurs fois.
La réaction habituelle, « tout mettre sur le modèle le plus puissant, effort maximal », ne règle que le premier problème, et aggrave le second.
Ce que les mesures d'Ayoub Hammoudi montrent
Ayoub Hammoudi a mesuré, en octobre 2026, 100 exécutions sans intervention de Claude Code, 3 par configuration, sur quatre tâches notées par des tests cachés ou un oracle : un correctif de parseur, six bugs subtils dans un cache, un algorithme de routage sous contraintes, et un moteur d'expressions régulières comparé à celui de Python sur 3 000 motifs aléatoires.
Résultats :
- Toutes les exécutions valides réussissent dès l'effort le plus bas, sur Haiku, Sonnet et Opus 5.5.
- Haiku, à l'effort le plus bas, a construit un moteur de regex identique à celui de Python sur les 3 000 cas, trois fois sur trois, pour 0,02 $.
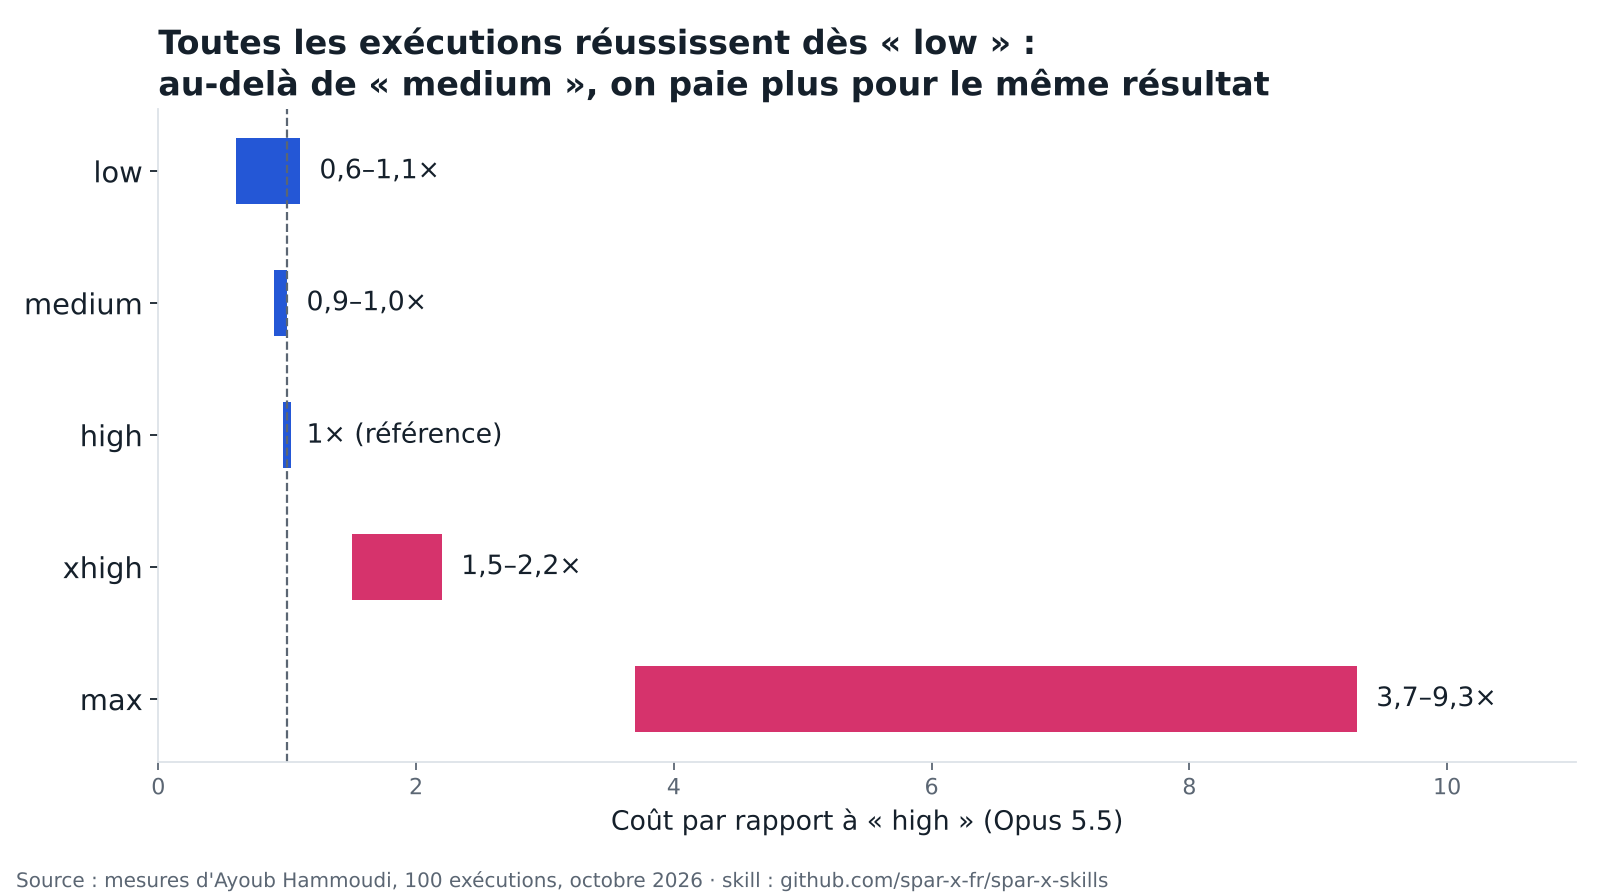
- Au-dessus de « medium », l'effort n'apporte rien de mesurable sur ces tâches. Il augmente seulement le coût et le temps :
| Coût par rapport à « high », même modèle | low | medium | xhigh | max |
|---|---|---|---|---|
| Sonnet 5.5 | 0,4 à 0,6× | 0,5 à 0,8× | 1,4 à 1,9× | 5,0 à 8,1× |
| Opus 5.5 | 0,6 à 1,1× | 0,9 à 1,0× | 1,5 à 2,2× | 3,7 à 9,3× (4 à 7 fois plus lent) |
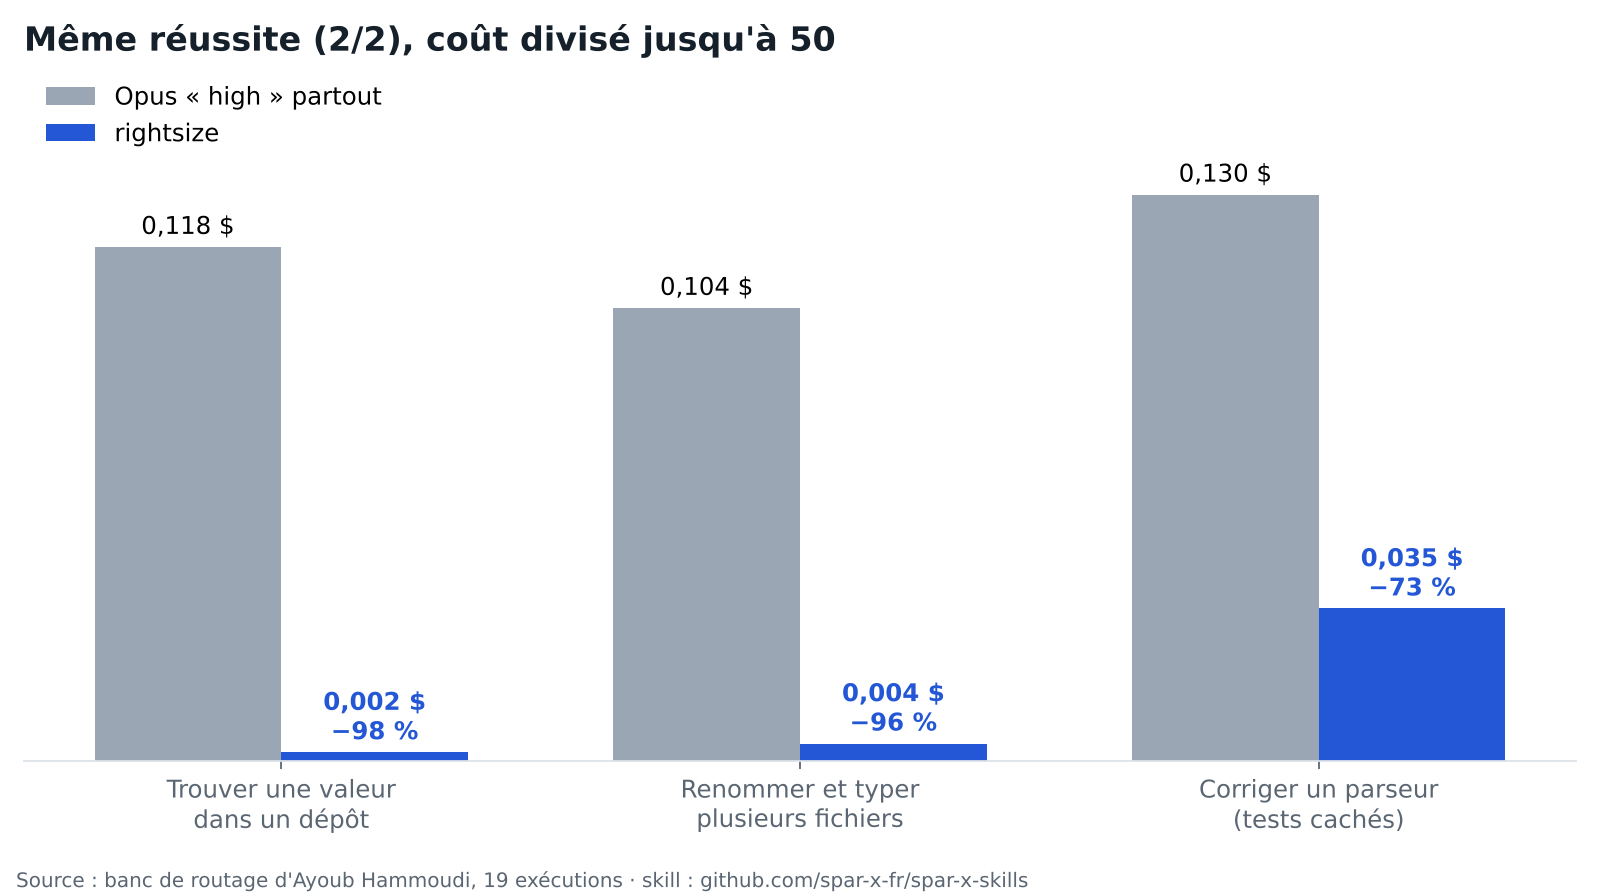
Sur un second banc de 19 exécutions, comparé à « Opus en high pour tout » :
| Tâche | Référence | rightsize | Coût | Réussite |
|---|---|---|---|---|
| Trouver une valeur dans un dépôt, avec leurres | 0,118 $ | haiku/low 0,002 $ | −98 % | 2/2 contre 2/2 |
| Renommer dans plusieurs fichiers, ajouter des types | 0,104 $ | haiku/low 0,004 $ | −96 % | 2/2 contre 2/2 |
| Corriger un parseur face à des tests cachés | 0,130 $ | sonnet/medium 0,035 $ | −73 % | 2/2 contre 2/2 |
Et pour les tests : 11,4 s pour la suite complète contre 0,7 s pour les seuls tests touchés par une modification d'un module.
Les limites, écrites par l'auteur lui-même : ces tâches sont bien spécifiées et vérifiables, là où un effort bas est le plus sûr ; rien ne mesure ici le travail ouvert (conception, revue), et les échantillons sont petits.
Comment rightsize s'en sert
La leçon centrale : quand un test prouve le résultat, c'est le test qui garantit la qualité, pas l'effort. rightsize en tire des règles concrètes :
- Noter chaque tâche sur quatre axes de 0 à 3 : périmètre, risque, ambiguïté, profondeur.
- Choisir le modèle et l'effort à partir de cette note : une lecture ou une recherche va sur Haiku en effort bas, du code standard sur Sonnet en effort moyen, un bug à la cause inconnue ou un changement risqué sur Opus.
- Démarrer un cran plus bas quand un contrôle existe (tests, oracle, compilateur), et monter seulement sur preuve : un test qui échoue deux fois, une revue qui trouve un défaut grave. Jamais par habitude.
- Garder un effort élevé là où aucun contrôle n'existe : conception, revue, cadrage.
- Tester ce que le changement touche pendant le travail, et la suite complète à la fin du sprint, avec un registre des passages complets.
- Protéger le cache : ne pas changer de modèle en pleine session, ce qui réécrit tout le cache, et passer plutôt par des sous-agents.
La skill rightsize, publiée par Spar-x, contient la stratégie complète (SKILL.md), des playbooks d'expert par type de travail (bug, fonctionnalité, refactorisation, revue, migration, performance…) et la référence de routage des modèles et de l'effort.
Pourquoi ça compte pour un dirigeant
La question n'est pas « quel modèle acheter », mais « quel niveau d'effort pour quelle étape ». Une équipe qui pilote ses agents avec méthode peut garder une qualité d'expert et réserver le budget aux étapes où la réflexion change vraiment le résultat. C'est aussi un sujet de gouvernance : savoir où partent les tokens se mesure, et rightsize donne la méthode pour le faire.
L'essayer
La skill est disponible en open source (licence MIT) dans le dépôt de Spar-x, spar-x-fr/spar-x-skills, que je co-maintiens avec Ayoub Hammoudi. Dans Claude Code :
/plugin marketplace add spar-x-fr/spar-x-skills
/plugin install spar-x-skills@spar-x-skills
Ou copiez le dossier skills/rightsize/ du dépôt dans ~/.claude/skills/.
À retenir
- L'effort maximal coûte jusqu'à 9 fois plus que « high », pour le même résultat sur des tâches vérifiables.
- Un contrôle automatique (tests, oracle) permet de démarrer bas et de monter sur preuve.
- L'effort élevé se garde pour ce qu'aucun test ne peut juger.
Sources : baisse des limites hebdomadaires de Claude Code (BleepingComputer), mesures publiées par Ayoub Hammoudi avec rightsize (octobre 2026), skill rightsize sur GitHub.
Zakaria Khchiche, Tech Lead Data & IA freelance à Paris, plus de 200 agents IA en production, contributeur à Mistral AI (mistral-common) et à Microsoft Agent Framework. LinkedIn. Former vos équipes à piloter l'IA : formation IA générative avec Spar-x, organisme certifié Qualiopi, finançable par votre OPCO. Demander un devis.